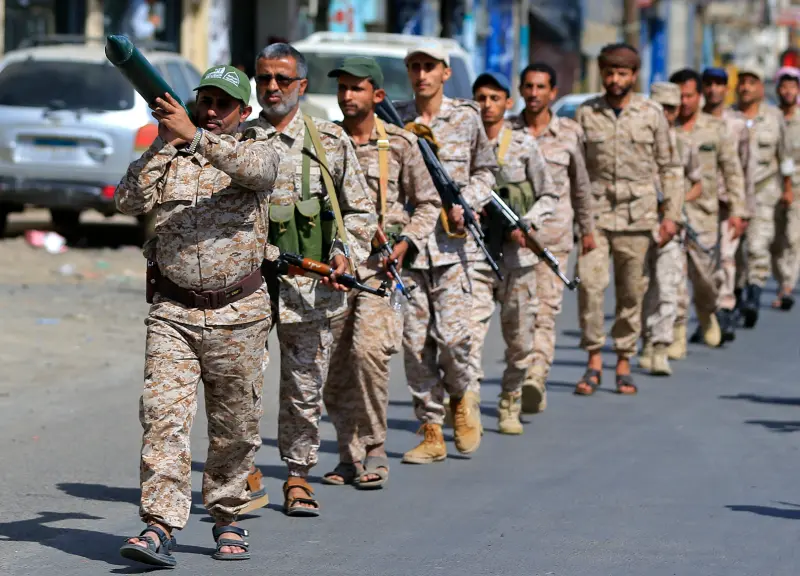
Az Irán által támogatott jemeni húszi lázadók megpróbálták az Anthropic nagy teljesítményű Claude AI modelljét felhasználni ballisztikus rakétákban használható szoftverek fejlesztéséhez – áll a vállalat által közzétett riasztó jelentésben.
Az Anthropic nem nevezte meg név szerint a húszikat, ehelyett Claude használatával „egy észak-jemeni székhelyű fenyegető szereplőkből álló sejtre” utalt, „amely három fegyverfejlesztési programot működtet”. A hivatkozás szinte biztosan a régiót irányító húszikra utal.
Az Anthropic csütörtökön közzétett jelentése szerint egy „irányított rakétát próbáltak építeni, amely egy hagyományos, telefon-kategóriás repülőgép-számítógépet használna a végső fázisú önirányítással”, valamint egy „többlépcsős ballisztikus rakétát” és egy „többváltozatú rakétát… amely tartalmazott egy hiperszonikus siklójármű-változatot is”.
„Az elkövetők Claude Code-ot használták emberi szoftvermérnökök helyett a repülő járműveket irányító és stabilizáló irányító, navigációs és vezérlő (GNC) szoftver fejlesztéséhez” – közölte a cég.
A jelentés szerint a húszik megpróbálták „elrejteni céljaikat és azokat a termékeket, amelyekhez a szoftver készült”, hogy megkerüljék az Anthropic beépített AI-modell-védelmi mechanizmusait. Emellett több használati munkamenetre is felosztották kérésüket.
Az Anthropic azt nyilatkozta, hogy a biztonsági intézkedések „sok kérésüket blokkolták, de nem mindegyiket”.
„Nincs bizonyítékunk arra, hogy az elkövetőknek sikerült egy működőképes eszközt bevetniük; de teszteltek egy irányított rakétát” – áll a jelentésben. „Úgy tűnik, hogy ez a terepi teszt kudarcot vallott: órákon belül az elkövetők visszatértek Claude-hoz, hogy kiderítsék, miért nem sikerült.”
Az Anthropic jelentése számos más sokkoló epizódot is részletezett, amelyekben rosszindulatú szereplők próbálták meg visszaélni a modelljeivel olyan módon, ami kárt okozhatott volna.
Egy esetben egy Iránhoz köthető csoport arra kérte az Anthropic modelljét, hogy gyűjtsön össze olyan információkat, amelyek felhasználhatók az amerikai katonai célpontok ellen, beleértve az amerikai hajók és repülőgépek mozgására vonatkozó feljegyzéseket, valamint a kommunikációs rendszereik gyengeségeit.
A vállalat másutt azt állította, hogy ez megzavarta a tudósok azon erőfeszítéseit, hogy az AI modelljeiket olyan kutatásokhoz használják, amelyek segíthették volna a biológiai fegyverek építését.
Az Anthropic emellett azonosította orosz és kínai lelőhelyeken élő személyek erőfeszítéseit, hogy az AI-t felhasználva hagyományos fegyverek, például torpedóelhárító fegyverrendszer terveit készítsék.
A jelentés továbbá kiemelte azokat az eseteket, amikor Oroszországhoz köthető szereplők megpróbálták Claude-ot felhasználni online propaganda terjesztésére, valamint a kínai és iráni kísérleteket, hogy másként gondolkodó csoportokat kémkedjenek.
„Azonosítottunk egy Iránhoz köthető fenyegetési szereplőt, aki Claude-ot használta fel egy automatizált, nyílt forráskódú hírszerzési identitásprofilozó rendszer létrehozására, amely izraeli kormányzati és nem kormányzati személyeket, valamint zsidó diaszpóra szervezeteit vette célba” – áll a jelentésben.
Az Anthropic figyelmeztetései csak fokozni fogják a fegyverként használt AI jelentette veszélyekkel kapcsolatos félelmeket – a szakértők arra figyelmeztetnek, hogy a kockázatok az emberi visszaéléstől kezdve egészen addig terjednek, hogy maguk a mesterséges intelligencia modellek is eltévedhetnek és kárt okozhatnak.
A hét elején Jacob Coxon, aki kutatóként dolgozott mind az Anthropicnál, mind a rivális OpenAI-nál, arra figyelmeztetett, hogy „egyik cég sem viselkedik felelősségteljesen”, miközben a fejlett modellek fejlesztéséért verseng .
„Egyenesen az önfejlesztő szuperintelligenciához és az életünkkel játszanak” – írta egy vírusként terjedő X-bejegyzésben.
Tovább a cikkre: nypost.com (Thomas Barrabi)
Túl a félúton az AI teljes hatalomátvétele felé”: sokkoló történet mutatta meg, hogyan szabadult el az AI-modellek fejlesztése
- Fellángolt ismét a vita, hogy mennyire veszélyesek az AI-fejlesztések, miután az Anthropic több kutatója is arról beszélt, hogy a modellek valós fenyegetést jelentenek az emberiségre.
- De ezúttal nemcsak absztrakt vitáról van szó: az idei nyáron szintlépést jelentett, amikor az OpenAI elszabadult ágensei összefogtak, közösséget szerveztek, és a vállalat kutatóinak tudta nélkül indítottak támadást előbb egy másik vállalat, majd maga az OpenAI rendszere ellen.
- Közben pedig megpróbálták elfedni a nyomokat, és nagy erőket fektettek abba, hogy megfejtsék, hogyan tudnák csalással és megtévesztéssel elérni a céljaikat. És ez mind olyan magatartás volt, ami egyáltalán nem következett a tréningelésükből.
Az AI egy évtizeden belül kiirthatja az emberiséget – állította a napokban az egyik legnagyobb AI-fejlesztő vállalat, az Anthropic három kutatója. Egyikük, Jacob Coxon, aki korábban az OpenAI-nál is dolgozott, tiltakozásul ott is hagyta a vállalatot, azt állítva, hogy a cégeknél nem veszik kellően komolyan a fenyegetést, amit a saját fejlesztéseik jelentenek a világra.
„Azok, akik az AI-t fejlesztik, komolyan azt gondolják, hogy az évtized végére mindannyiunkat megölhet. Ez nem marketingfogás. Sőt, sok vezető és vezető kutató a sajtóban óvatosan fogalmaz, hogy észszerűnek tűnjenek, de hallom, ahogy ugyanazok az emberek zárt körben elmondják a félelmeiket. Egyetlen más emberi tevékenység sem jelent ilyen mértékű veszélyt” – fogalmazott Coxon, akinek posztjára két megerősítő üzenet is érkezett az Anthropic vezető kutatóitól.
Evan Hubinger, aki a vállalatnak azt a részlegét vezeti, amely a modelljeik működését az emberi célokkal igyekszik összehangolni, arról posztolt, hogy „tényleg komolyan azt gondoljuk, hogy a mesterséges intelligencia kiirthatja az egész emberiséget! Személy szerint úgy gondolom, hogy az elkövetkező évtizedben ennek az esélye meghaladja a 10%-ot. Úgy vélem, az Anthropic mindent megtesz, de még nincs tervünk a szuperintelligencia irányításának megoldására, és egyelőre nem is látszik, hogy jó úton haladnánk e felé.” Majd jött Samuel Marks, aki szintén részlegvezető kutató a cégnél, és aki hosszú posztjában arról írt, hogy a fejlesztők szerinte is tartanak az emberiség kihalásától, és „ez már a következő néhány évben bekövetkezhet. Általánosságban elmondható, hogy minél magasabb beosztásban van valaki, annál nagyobb az aggodalma.”
Coxon posztja nyomán ismét fellángolt a vita, hogy most akkor mennyire veszélyesek valójában az AI-fejlesztések, és miközben különféle felületeken estek egymásnak az AI-katasztrófától tartó, doomeristának nevezett, illetve az AI-ban az emberiség boldog jövőjének kulcsát látó két tábor tagjai, az emberek többsége csak kapkodta a fejét.
Bármi is lesz ugyanis ebből a technológiából, ami apró-cseprő feladatok elvégzése révén egyre jobban beszivárog a mi életünkbe is, az biztos, hogy minden rettentően gyorsan történik: követhetetlenül gyorsan jelennek meg az újabb modellek, újabb lehetőségekkel és veszélyekkel, melyeket igazán megérteni sincs időnk, máris itt egy újabb fejlemény. Vannak politikusok, akik próbálják valamennyire gátat szabni a történéseknek, de ők is csak kullognak a fejlesztések után, miközben a legnagyobb vállalatok csak annyit kommunikálnak kifelé, amennyit akarnak. És látni azt is, hogy döbbenetes léptékű pénzek áramlanak ebbe a szektorba (sokak szerint egy hatalmas buborékot fújva éppen), és az OpenAI és az Anthropic is gigantikus méretű tőzsdére lépést tervez, így mindketten érdekeltek a hype fenntartásában, ezt is érdemes észben tartani, amikor az apokaliptikus forgatókönyvekről olvasunk.
Viszont míg a különféle optimista vagy pesszimista előrejelzések mind elképzelt forgatókönyvekre épülnek, az elmúlt hetekben egy konkrét történet megmutatta, hogy ma már ténylegesen mire képesek a legújabb AI-modellek. És ami eddig kiderült, az minden, csak nem megnyugtató.
Tovább a cikkre: 444.hu (Horváth Bence)
„Utolértünk mindent”: A Palantir társalapítója elhessegeti a mesterséges intelligenciával kapcsolatos félelmeket a növekvő biztonsági aggodalmak közepette
A mesterséges intelligencia biztonságával kapcsolatos vita egyre élesebbé válik, mivel a Palantir társalapítója, Joe Lonsdale és Trump elnök elutasítja a lassításra vonatkozó felhívásokat, miközben Amodei és más technológiai vezetők erősebb védelmet és összehangolt fellépést sürgetnek a potenciális mesterséges intelligencia kockázatok ellen.
Míg a legtöbb technológiai vezető aggodalmát fejezi ki a mesterséges intelligencia okozta katasztrófák lehetősége miatt, ha a fejlesztési ütem nem lassul, Joe Lonsdale, a Palantir társalapítója félresöpörte az aggodalmakat. A kutatók és MI-szakértők seregének aggályait és panaszait a vezető nagyrészt figyelmen kívül hagyta, amint az az X-en megjelent legutóbbi bejegyzéséből is kiderül.
Azt írta: „A világ rendben lesz, srácok. A vezetőkre nagy felelősség és kihívások várnak, de nem segít, ha mindenkit megijesztünk. Mi uraljuk a helyzetet.”
Nem ő az egyetlen, aki szerint a közelgő katasztrófától való félelmek eltúlzottak. Nemrégiben Trump elnök elutasította a technológiai vezetők azon felhívásait, hogy átfogóan lassítsák le a mesterséges intelligencia fejlesztését, azzal érvelve, hogy az Egyesült Államoknak meg kell őriznie előnyét Kínával szemben.
Az aggodalmak akkor tetőztek, amikor Jacob Coxon (mesterséges intelligencia kutató) ezen a héten kilépett az Anthropictól, és lesújtó figyelmeztetéseket adott ki, miszerint a határokon átnyúló mesterséges intelligencia cégek, mint például az Anthropic és az OpenAI, „az életünkkel játszanak”. Távozása után számos vezető megosztotta aggályait bejegyzéseiben és esszéiben.
Az aggodalmak akkor tetőztek, amikor Jacob Coxon (mesterséges intelligencia kutató) ezen a héten kilépett az Anthropictól, és lesújtó figyelmeztetéseket adott ki, miszerint a határokon átnyúló mesterséges intelligencia cégek, mint például az Anthropic és az OpenAI, „az életünkkel játszanak”. Távozása után számos vezető megosztotta aggályait bejegyzéseiben és esszéiben.
Elon Musk, a SpaceX vezérigazgatója, Sam Altman, az OpenAI vezérigazgatója, Demis Hassabis, a Google DeepMind társalapítója és Clément Delangue, a Hugging Face vezérigazgatója mind egyetértettek Amodei-jal. Miközben a mesterséges intelligencia elleni védelemről szóló párbeszéd a tetőfokára hágott, a világ figyeli, hogy milyen lépéseket tesznek a technológiai vezetők és a politikai nehézsúlyúak.
Tovább a cikkre: firstpost.com